·
2 Min. Lesezeit
4chems AI Connector: Sicherer KI-Zugriff auf IUCLID-6-Daten
Es ist an der Zeit zu teilen, woran wir gearbeitet haben: AI Connector.
Mehr lesen →Haben Sie Fragen? Wir helfen gerne.
Eine Studie auf der Eurotox 2026 zeigt: KI-Modelle stimmen konsistenter überein als menschliche Toxikologen. Was das für Ihre IUCLID-Altdaten bedeutet.
Haben Sie Fragen? Wir helfen gerne.
Die Toxikologie folgt einigen der strengsten Laborstandards der Wissenschaft: OECD-Leitlinien, GLP-Protokolle, validierte Assays. Eine auf der Eurotox 2026 vorgestellte Studie zeigt: Nicht die Laborarbeit ist der inkonsistente Teil. Es ist die Auswertung.
Im Rahmen der HESI-CITE-Lecture stand das Team von Jess Ewald (EMBL-EBI) vor einem vertrauten Problem: über 100.000 unstrukturierte toxikologische Befunde, gesammelt über Jahrzehnte aus Tierstudien verschiedener Labore, in unterschiedlichen Formaten und nach unterschiedlichen Konventionen. All das musste auf eine standardisierte Ontologie (die Mammalian Phenotype Ontology) abgebildet werden, bevor es sich in großem Maßstab weiterverwenden ließ.
Eine manuelle Zuordnung in diesem Umfang ist nicht realistisch. Das Team baute daher eine LLM-gestützte Pipeline. Schon ihr Aufbau war Expertenarbeit: Toxikolog:innen legten fest, wie Befunde der Ontologie zugeordnet und wie die Ergebnisse bewertet werden. Anschließend testete das Team die Pipeline gegen sieben erfahrene Toxikolog:innen, die dieselbe Zuordnung von Hand vornahmen.
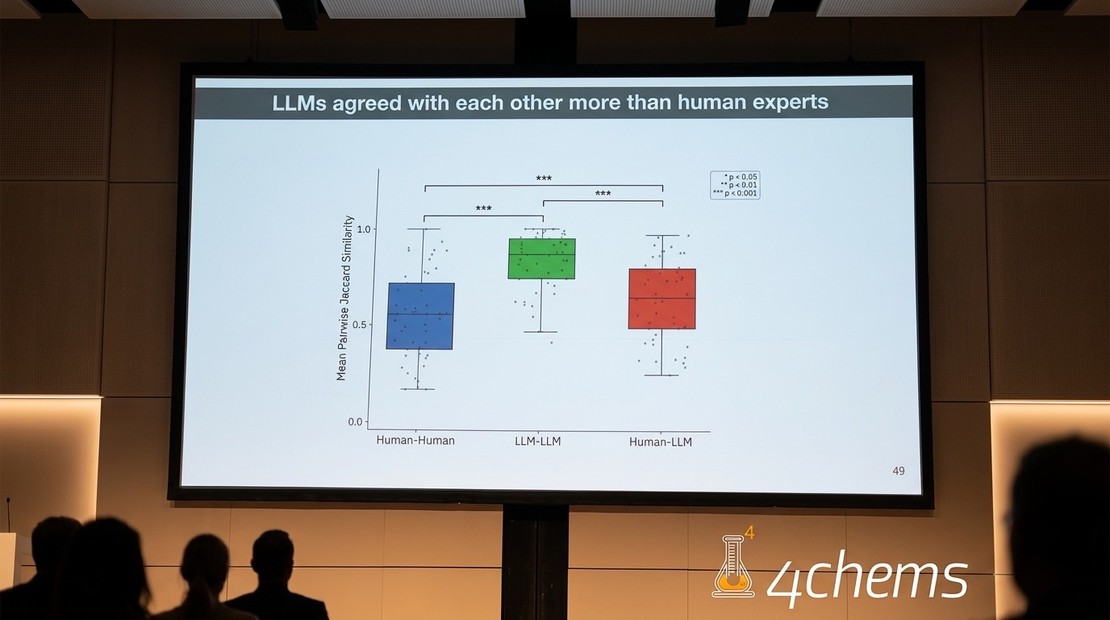
Gemessen an der mittleren paarweisen Übereinstimmung (Jaccard-Ähnlichkeit):
| Vergleich | Übereinstimmung |
|---|---|
| LLM ↔ LLM | 0,85 |
| Mensch ↔ LLM | 0,60 |
| Mensch ↔ Mensch | 0,55 |
Jeder Unterschied war signifikant bei p < 0,001. Jedes einzelne Modell lag näher an der durchschnittlichen menschlichen Antwort als jede einzelne Expertin oder jeder einzelne Experte an den eigenen Kolleg:innen.
Die Modelle waren konsistenter als die Expert:innen.
Wir stecken viel Energie in die Frage, ob KI zuverlässig genug für regulatorische Arbeit ist. Dieses Ergebnis stellt die schwierigere Frage in die andere Richtung: Wie zuverlässig ist eigentlich die Experteneinschätzung, auf der bestehende Dossiers bereits aufgebaut sind?
Diese Frage ist für niemanden abstrakt, der eine gewachsene IUCLID-Instanz verwaltet. Jedes über Jahre gepflegte Dossier enthält dieselbe Art von Material: Endpunkt-Zusammenfassungen und Einstufungsbegründungen, verfasst von unterschiedlichen Prüfer:innen, in unterschiedlichen Jahren, in leicht unterschiedlichen Formulierungen. Nichts davon ist technisch falsch. Nur wenig davon stimmt exakt mit dem benachbarten Eintrag überein. Ein typischer Fall: Eine Zusammenfassung zur Hautsensibilisierung kommt zu „nicht sensibilisierend“, die nächste zu „kein hautsensibilisierendes Potenzial“. Beides bedeutet dasselbe, doch eine Suche, ein Filter oder ein automatischer Export behandelt es als zwei verschiedene Antworten.
Niemand markiert das als Fehler, denn ein Fehler ist es nicht — es ist Drift. Und diese Drift bleibt unsichtbar, bis jemand zwei Dateien nebeneinander lesen und entscheiden muss, welche Version tatsächlich korrekt ist. Bei einer Migration, einem Audit oder einer Einreichungsprüfung hat diese Entscheidung reale Konsequenzen.
Die Studie zeigt auch, woher Konsistenz kommt. Nicht von einem Modell, das sich selbst überlassen wird, sondern von Expert:innen, die einmal sorgfältig festlegen, wie ein Befund zu lesen ist, und diese Entscheidung in einen Prozess einbauen, der sie jedes Mal gleich anwendet. Für eine andere regulatorische Fragestellung müssten sie diese Entscheidungen neu treffen.
Altdossiers haben das umgekehrte Problem: Das Expertenwissen steckt vollständig darin, wurde aber immer wieder neu angewendet, von verschiedenen Menschen, auf leicht unterschiedliche Weise.
Es gibt keinen magischen LLM-Zauberstab. Konsistenz entsteht, wenn Expert:innen den Entscheidungskontext festlegen, die Regeln definieren und die Ergebnisse prüfen. Die KI wendet dieses Urteil dann jedes Mal gleich an. Ersetzen kann sie es nicht.
Genau diese Lücke soll eine strukturierte, gut gepflegte Infrastruktur schließen. Vor einer Migration gehen wir dabei in drei Schritten vor:
Wenn Sie wissen möchten, wie viel Inkonsistenz in Ihren eigenen Altdossiers steckt: Genau das prüfen wir vor einer Migration zu 4chems.com. Sprechen Sie mit uns darüber, was eine strukturierte, aktuelle IUCLID-Umgebung in Ihren Daten sichtbar machen würde.
Quelle: Jess Ewald, HESI-CITE-Lecture, „Connecting chemical effects across biological scales with AI“, Eurotox 2026, Wien.
Es ist an der Zeit zu teilen, woran wir gearbeitet haben: AI Connector.
Mehr lesen →
Ja, es gibt einen MCP-Server für IUCLID. 4chems betreibt einen öffentlichen Remote-Server nach dem
Mehr lesen →
Die Debatte über Cloud- und KI-Tools in der REACH-Compliance dreht sich meist um ein Wort: Risiko.
Mehr lesen →Die Tools und Lösungen hinter diesen Einblicken — verwaltetes IUCLID, CHESAR und QSAR Toolbox in der EU-Cloud.